
Agent Lightning v1.0:3500行轻量级智能体强化学习框架
19 小时前 3 阅读来源:Microsoft Research Blog
AI 中文改写
原文为英文,由 AI 改写为中文报道,内容完整。如需参考原文请点击下方链接
微软亚洲研究院近日开源了Agent Lightning v1.0,一个仅约3500行代码的轻量级智能体强化学习框架。它的核心主张是:让部署时使用的同一个智能体框架(agent harness)直接参与强化学习训练,不再需要开发者在训练框架里重新实现一遍智能体。换句话说,你线上跑的是什么,训练的就是什么。
这件事的背景值得展开。AI智能体已经从单一模型演变为由模型、工具、执行环境组成的复杂全栈系统,其能力越来越依赖模型之外那层负责协调的“框架”——也就是harness。强化学习本可以让这些智能体变得更强,但传统方案有个根本性假设:训练框架必须自己掌控与环境的交互循环。像verl、AReaL、slime这类早期RL系统都是这么设计的,结果就是训练一个智能体,得先把它的循环逻辑在RL框架里重建一遍。问题是,如今真实的harness早已超出这个假设——mini-SWE-agent、OpenHands、OpenCode、Claude Code、Codex各有各的上下文管理、工具协议、执行逻辑和依赖。重建不仅昂贵,而且重建出来的智能体行为可能和实际部署的版本对不上,训练效果自然打折扣。
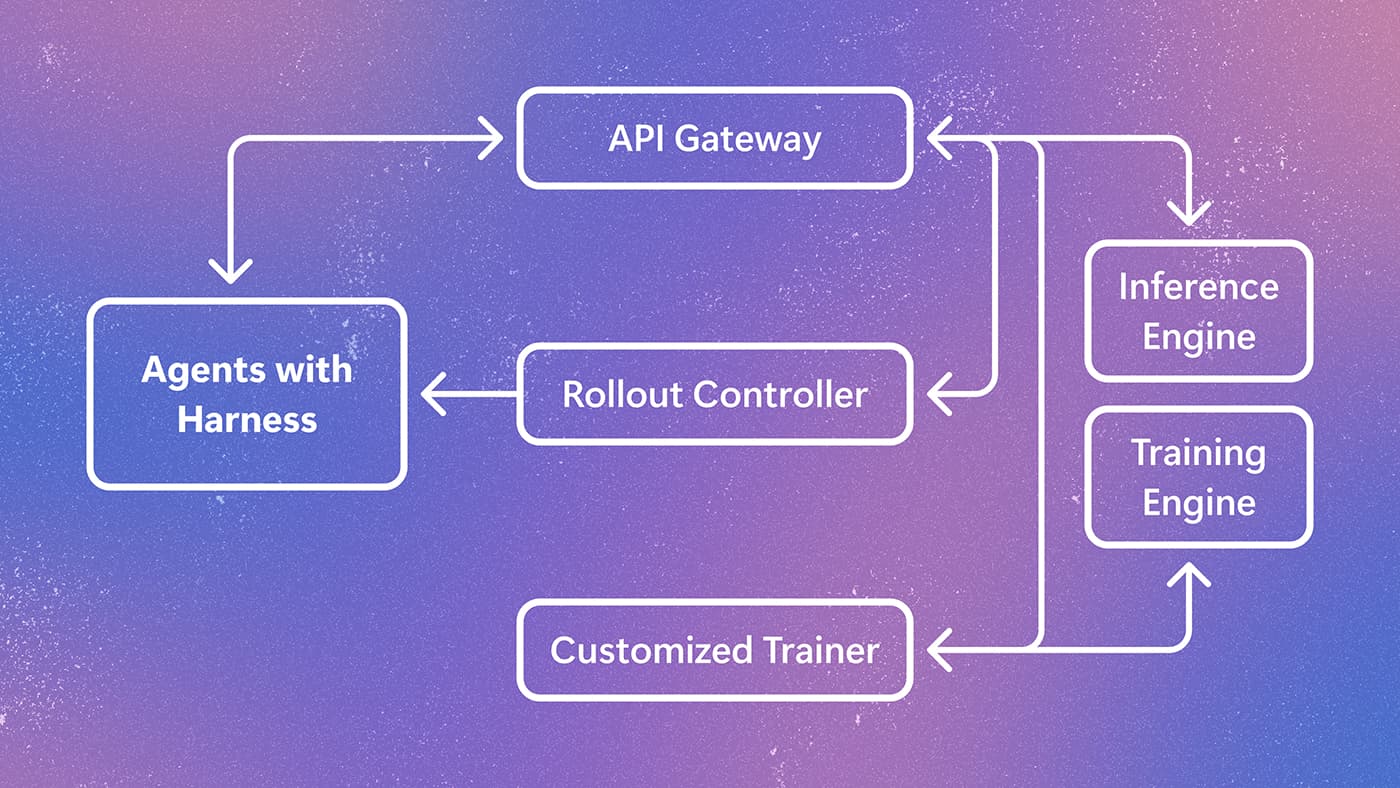
Agent Lightning的解法是在智能体和模型之间插入一个LLM代理层。智能体照常运行,只需把原来调用模型API的端点指向Agent Lightning,训练框架就能观察并记录它的模型调用。v1.0进一步把这套思路正式定义为Harnessed Agentic RL。几个关键改进值得关注:整个框架约3500行代码,小到足以理解、修改和扩展;原生支持Kubernetes,智能体直接以K8s任务形式运行,不依赖付费的商业沙箱服务,自管集群、云上K8s或本地基础设施都能支撑规模化rollout;官方还给出了一个完整的编码智能体训练样例——基于约6000条开源数据集样本,把Qwen3.5-9B在SWE-bench Verified上的Pass@1从41.8%提升到56.4%,绝对提升14.6个百分点。对做智能体产品的团队来说,这意味着训练成本和对齐风险都可能显著降低,尤其是那些已经围绕Claude Code、Codex等成熟harness构建工作流的开发者,不必再为训练另起炉灶。
这篇文章对你有帮助吗?
觉得有用?分享给更多人
留言 · 0 条
暂无留言,来说两句吧