
AI评分 一般 (57)AI 中文改写
AI隐藏存储账单:推理留下了什么
5 小时前 1 阅读来源:MIT Technology Review
AI 中文改写
原文为英文,由 AI 改写为中文报道,内容完整。如需参考原文请点击下方链接
大多数企业高管在估算AI成本时,脑海里浮现的往往是GPU——成排的加速器、以吉瓦计的电力和排着长队的芯片订单。但这幅图景漏掉了一块:数据存储成本。模型给出回答之后,数据去了哪里?每天数十亿条提示词、图片和视频所产生的后端数据,大部分都需要被存储下来。然而存储恰恰是AI基础设施规划中最难预估、也最容易被忽略的一环。
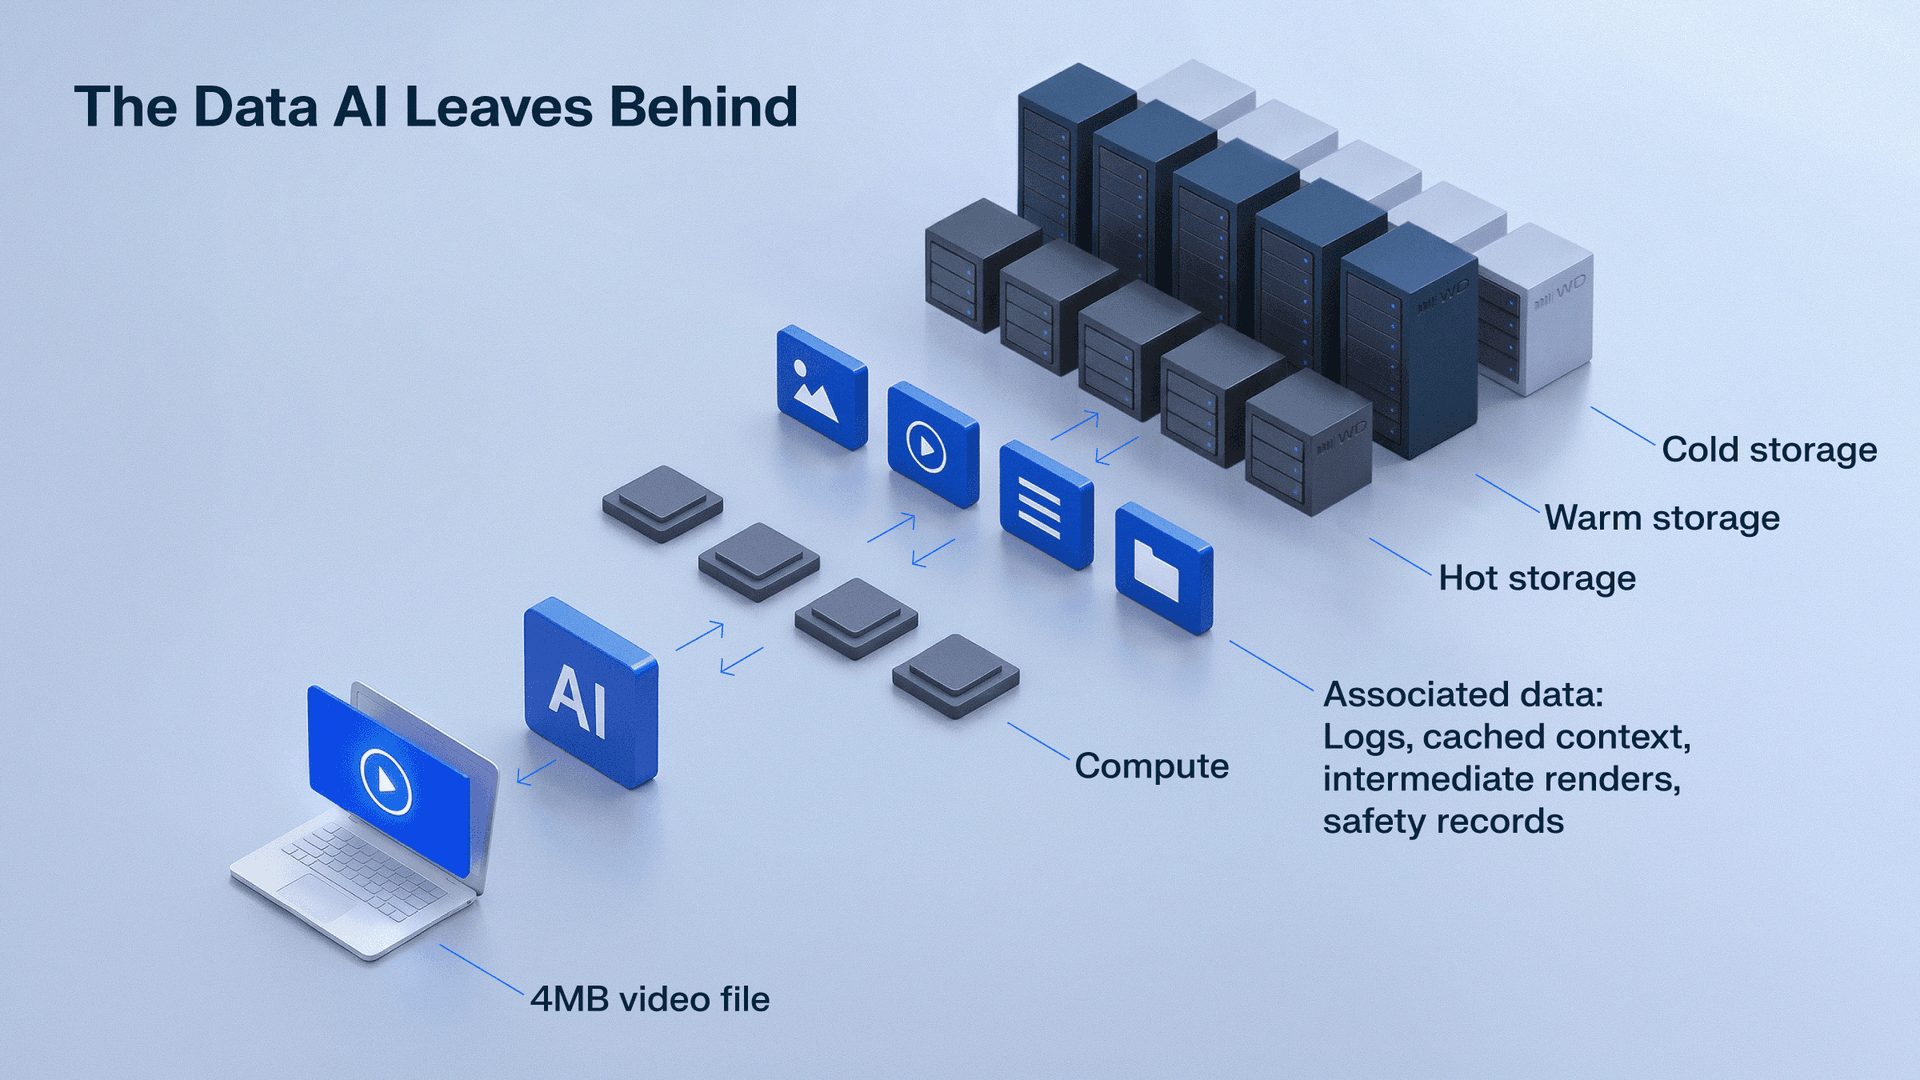
这种忽视的代价正在显现。传统上,AI基础设施的讨论围绕训练展开,而训练是有限度的:一次训练任务启动、消耗算力、然后结束。推理却不同,它持续运行,每一次模型回答提示词都在产生新的数据残留。以AI生成视频为例,西部数据(WD)的内部测量显示,一段8秒的720p视频(用户拿到的文件仅3.97MB)在后端留下的关联数据超过500MB,包括日志、缓存上下文、即时渲染、备份和安全记录,是用户所见文件体积的130倍。如果企业生成更长、更高分辨率的视频,单条片段的后端数据量可膨胀到数百GB。而这类需求正在快速增长:麦肯锡预测,到2030年AI推理需求的年复合增速为35%,高于训练的22%,届时将占数据中心总需求的四成以上。WD委托IDC进行的一项全球调查(覆盖763名IT和业务决策者)也印证了这一趋势——近95%的受访者表示过去12个月生成式AI导致数据量增加,约61%称增幅达到25%或以上。
问题的棘手之处在于,存储需求不会像算力那样随训练周期回落。模型日志、合成输出、推理结果持续累积,企业保留数据的时间也越来越长。过去被归档、很少再调取的信息,如今可能成为未来AI工作负载的输入,这让存储不仅要扛住容量增长,还要支撑越来越频繁的动态调用。同一项调查中,96%的受访者预计需要更快的归档检索能力来支持推理或RAG(检索增强生成)。对CFO和CIO而言,这意味着“AI基础设施预算”如果只盯着算力,视野就太窄了——GPU等数据空转和等GPU一样烧钱,而存储瓶颈往往在已经酿成问题之后才浮出水面。
这篇文章对你有帮助吗?
觉得有用?分享给更多人
留言 · 0 条
暂无留言,来说两句吧