
AI评分 一般 (55)AI 中文改写
利用RetroChimera提升大规模小分子合成预测
10 小时前 1 阅读来源:Microsoft Research Blog
AI 中文改写
原文为英文,由 AI 改写为中文报道,内容完整。如需参考原文请点击下方链接
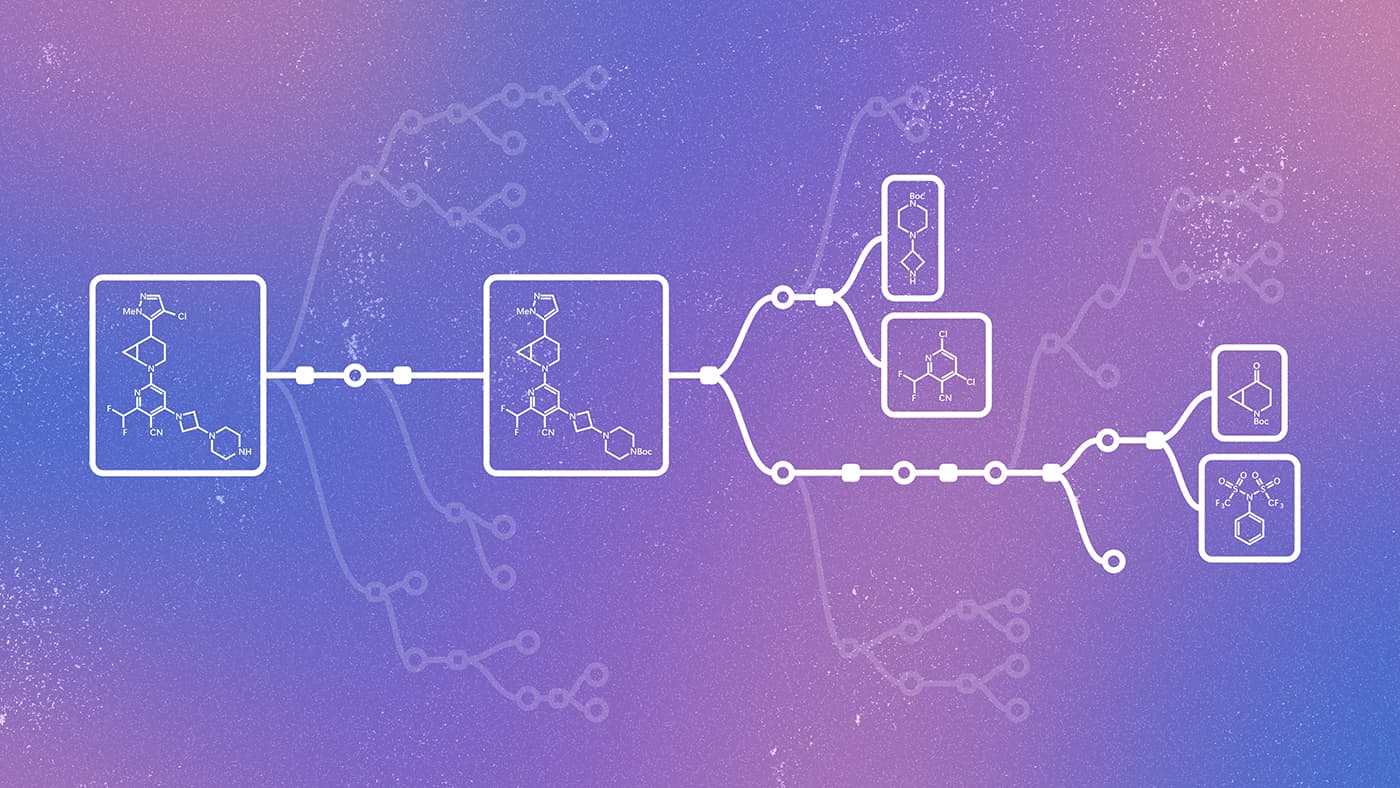
微软研究院近日在《自然》杂志上发表了逆合成预测模型RetroChimera,并宣布开源其实现代码和模型权重。这个模型要解决的问题很具体:新药和新材料的研发离不开新分子,但“怎么把这个分子造出来”这件事,目前仍然高度依赖化学家的手工规划,既慢又贵。RetroChimera能自动给出高质量的合成路线,在盲测中,拥有博士学位的化学家对它的单步反应预测的评价,甚至高于此前的模型和已发表的文献反应记录。
逆合成(Retrosynthesis)的思路是“倒着推”:从目标分子出发,一步步拆解成更简单的前体,直到拆到可以直接买到的原料为止。这个过程很像下棋——既要考虑眼前这一步有哪些走法,又要有全局策略把整条路线走通。但逆合成的“棋盘”比围棋复杂得多,可能的走法数量极其庞大,而且对某个分子来说哪些反应可行并不直观。现有系统普遍面临几个难题:难以召回罕见但战略上重要的反应类型、超出训练数据分布后表现不稳定、预测结果和化学家的直觉不符。这导致逆合成往往需要高度专业的知识,成为科学发现规模化和自动化的瓶颈。
RetroChimera的解法是“集成加学习排序”。它把两个能力互补的模型组合起来:一个是基于Transformer的从头生成模型R-SMILES 2,直接从输入分子预测前体分子,优势是能灵活地从数据中学习反应模式,但缺点是生成不受约束,容易产生“幻觉”式的错误预测;另一个模型补上这一短板,两者各自的提案再通过一个学习排序(learning-to-rank)策略进行聚合,最终输出比任何单一模型都更好的预测。论文还展示了模型在专有数据集上的零样本迁移和微调能力。对AI从业者来说,这个框架的启发在于:它并不局限于深度学习模型作为预测来源,理论上还可以接入反应数据库查询或人工反馈回路,这为把领域知识和大模型结合提供了一个可扩展的范式。对医药和材料研发领域而言,开源代码和权重意味着更多团队可以在此基础上加速新分子合成路线的探索,降低药物开发中合成环节的时间和成本。
这篇文章对你有帮助吗?
觉得有用?分享给更多人
留言 · 0 条
暂无留言,来说两句吧